使用 AI_EXTRACT 从文档中提取信息
AI_EXTRACT 是一个 Cortex AI 函数,允许您从文本或文档文件中提取结构化信息(如实体、列表和表),方法是用自然语言提出问题或描述要提取的信息。它可以与其他函数结合使用,为各种用例创建自定义文档处理管道(请参阅 Cortex AI 函数:文档)。
AI_EXTRACT 可以处理多种语言、多种格式的文档,并从文本密集型段落以及图形形式的内容中提取信息,例如徽标、手写文本(如签名)、表格或复选框标记。AI_EXTRACT 可以提取以下结构化格式的信息:
实体:用自然语言提问或描述要提取的信息(如城市、街道或 ZIP 代码)。
列表(或数组):您可以提供用于提取文档中信息数组或列表的 JSON 架构,例如银行对账单中所有账户持有人的姓名或文档中所有地址的列表。
表:提供 JSON 架构,以通过指定表标题和应提取的列的列表,来提取文档中的表数据。
AI_EXTRACT 通过同时处理多个文档,自动根据您的工作负载进行扩展。可以直接从对象存储中处理文档,以避免不必要的数据移动。
备注
AI_EXTRACT 目前与自定义 网络策略 不兼容。
小技巧
有关 AI_EXTRACT 的更多信息,包括支持的语言、区域可用性和费用,请参阅 AI_EXTRACT。
提取质量
AI_EXTRACT 使用 arctic-extract,一种基于视觉的专有大型语言模型 (LLM),来实现高精度提取。下表列出了该模型在各种标准基准测试中的得分,并与其他热门模型的得分进行了比较:
视觉问答 (VQA)
产品或服务 |
DocVQA 得分 |
|---|---|
人工评估 |
0.9811 |
Snowflake Arctic-Extract |
0.9433 |
Azure OpenAI GPT-o3 |
0.9339 |
Google Gemini 2.5-Pro |
0.9316 |
Google Anthropic Claude 4 Sonnet |
0.9119 |
Azure Document Intelligence + GPT-o3 |
0.8853 |
Google Document AI + Gemini |
0.8497 |
Azure OpenAI GPT-o3 |
0.9339 |
AWS Textract |
0.8313 |
纯文本问答 (SQuAD v2)
产品或服务 |
ANLS |
完全匹配 |
|---|---|---|
Snowflake Arctic-Extract |
81.18 |
78.74 |
Anthropic Claude 4 Sonnet |
80.54 |
77.10 |
Meta LLaMA 3.1 405B |
80.37 |
76.56 |
Meta LLaMA 4 Scout |
74.30 |
70.70 |
OpenAI GPT 4.1 |
70.71 |
66.81 |
Meta LLaMA 3.1 8B |
59.13 |
54.48 |
提取信息的问题优化
使用 AI_EXTRACT 时,请使用自然语言询问有关文档的问题。要提出能返回准确答案的问题,请遵循以下准则:
使用简单的英语。
针对每一个问题,了解您期望获得怎样的答案。
请具体说明;例如,如果文档中包括几个日期(如发布日期和签名日期),不要在未提供更多细节的情况下询问“日期是什么?”。
在每个问题中只询问一个值。
不要指望 AI_EXTRACT 猜测您的意图,或指望它在特定领域有广泛的知识。
以下面的文档为例。此购买和销售协议包括诸如要约到期日期、买卖双方名称以及所含项目等信息。
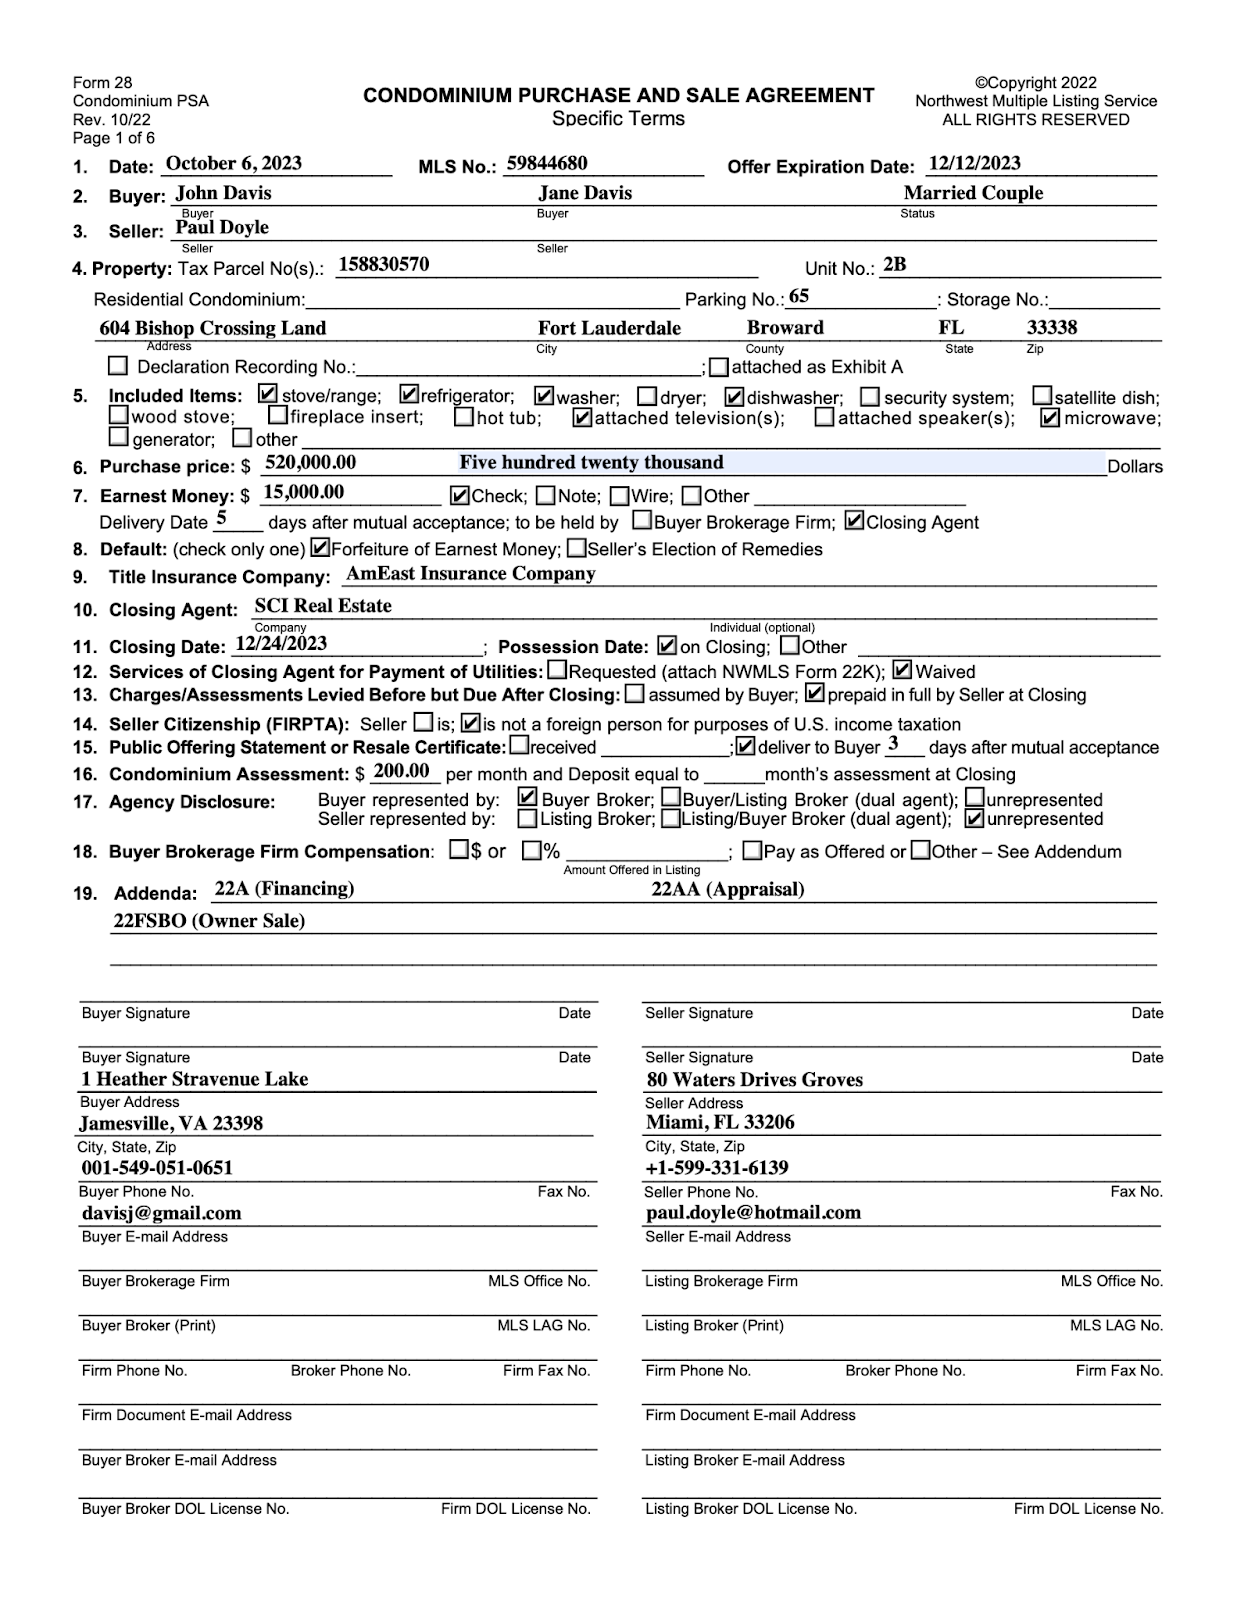
下表提供了您可以向 AI_EXTRACT 提出的问题的示例以及预期答案。
示例问题 |
答案 |
|---|---|
这份协议的日期是什么时候? |
|
公寓套件的买家是谁? |
|
该住宅单元中有哪些家用电器? |
|
公寓内没有哪些物品? |
|
公寓里有烘干机吗? |
|
这份购买和销售协议有哪些附录? |
|
卖方的传真号码是多少? |
无 |
表格上有买家的签名吗? |
|
MLS 号码是多少? |
|
这处房产的地址在哪里? |
|
表提取:最佳实践
本部分提供了在 AI_EXTRACT 中进行表格提取时的最佳实践。
为特定类型的文档使用一个架构
每个提取工作负载必须包含相同类型的文档,并且大多数表格中要提取的数据应具有相似性。如果源文档中的列数因文档而异,但所有文档都包含要提取的定义子集列,且这些公共列的名称和位置相同或相似,则可以提取这些公共列。
例如,发票可能包含不同数量的列和各种数据,但如果所有表格的前三列相同(Item Description、Quantity、Price)则这些数据可以被提取。
使用自然语言定义列名
您可以从文档中复制列名,以确保它们完全一致。例如,不要将列命名为 product_code 或 REPORT_DATE;应将它们命名为 Product Code 或 Report Date。
跳过空行
创建微调数据集时,跳过没有答案的行(其中返回的答案将是 None)。
按照文档中出现的顺序定义列
为提高准确性,请按照文档中列的出现顺序定义列,通常是从左到右,或者对于 转置表格,则从上到下。如果您选择以不同的方式定义顺序,则可能需要训练。
但是,对于有多行的值相同的列,例如 Invoice Number 和 Invoice Date,应将这些列放在开头。例如:
Invoice NumberInvoice DateItem CodeItem NameQuantity
使用文档中的大小写定义数值
在可能的情况下,请使用文档中的大小写(大写和小写)来定义数值。如果文档中的大小写不一致,请使用首字母大写。
使用描述字段
AI_EXTRACT 响应格式中的 description 字段是可选的;在大多数情况下不必填写。但是,如果文档中有多个相似的表格,则模型的回答可能不准确。如果答案来自与预期不同的源表格,或是模型找不到表,请尝试使用 description 字段。添加有助于模型识别正确表格的信息,例如表格标题或数字。
添加章节列来描述表格的布局
如果表分为多个命名部分,请添加一个分区列。这有助于模型更好地理解布局,从而提高准确性。例如,您可以将列命名为 Section、Item section 或 Item category。如果章节中有第二层嵌套,则可以添加两列:Section 和 Subsection。
要对值进行分组,请另外创建一列
您可以向现有表添加一列,以对值进行分组。通过这种方式,您可以将整个文档集的结果联接到一个表中。例如:
发票编号 |
物品详情 |
物品价格 |
数量 |
|---|---|---|---|
A |
物品 A1 |
10.00 |
1 |
A |
物品 A2 |
20.00 |
1 |
A |
物品 A3 |
30.00 |
1 |
B |
物品 B1 |
15.00 |
1 |
B |
物品 B2 |
25.00 |
1 |
B |
物品 B3 |
35.00 |
1 |
请注意,第一列的值会在对应的物品中重复出现。
使各文档之间的列名可区分
尝试从语义上区分一列。不要使用诸如 col1、val1、item1 之类的名称。
在某些情况下,转置可能效果更好,尤其是当行名在各文档之间相同或仅略有差异且属于有限的取值范围时。
请注意,对指定列集进行训练可能会提高结果的准确性。
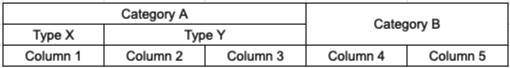
在处理层级标头时,将父级名称用作前缀
要从具有层级标头的表格中提取信息,请将标头路径连接起来,每个父级名称作为前缀。例如,对于下表,将列定义为:
Category A Type X Column 1Category A Type Y Column 2Category A Type Y Column 3Category B Column 4Category B Column 5
如有需要,对表格进行转置
您可以通过使用文档中表格第一列的值作为输出表格的列名,从转置表格中提取信息。
例如,对于下列表格,将列命名为:
Type A: Item 1Type A: Item 2Type B: Item 3Type B: Item 4
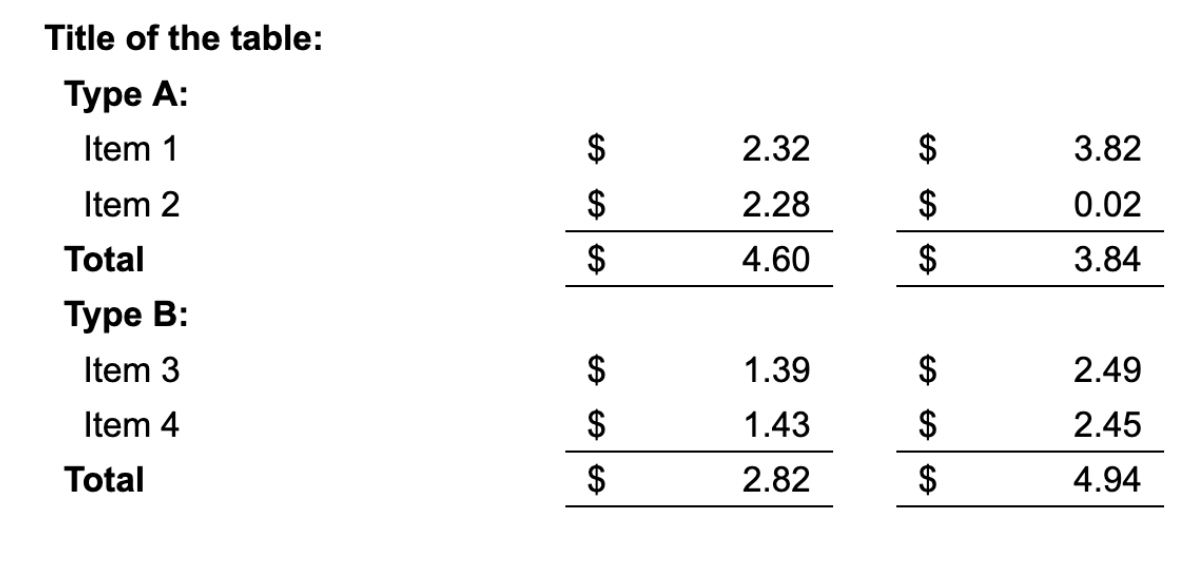
请注意,此示例包含 分层标头。
对于大型表格,拆分文档
表格提取模型返回的答案最长可达 4096 个词元。这意味着模型在达到该限制时会停止提取。您可以通过以下方式来实现:
如果表格跨越多页,请将文档拆分为多个单页文档,并在后处理阶段合并结果。
如果表格过于密集,以至于即使在单页上也无法提取数据,请按列拆分表格。
例如,如果表格包含 10 列,可以尝试定义两个独立的值:一个取表格左半部分的 5 列,另一个取右半部分的 5 列。您可能需要对列的选择进行试验,以获得最佳效果。
为文档中没有名称的列创建列名
如果文档中的第一列没有名称,则在定义该值时必须自行创建列名。您可以通过以下方式处理:
使用表格标题或标题中的重要部分。
创建一个能代表列中数据的名称,例如
description、type of asset、year、category。
比较两个不同时期的数据
如果您想比较两个不同时期的数据,例如在年度报告等财务文档中比较 2023 年和 2024 年的数据,可以在列名前添加“current”和“previous”前缀。请注意,可能需要进行训练以提高结果的准确性。
示例:从购买和销售协议中提取信息
以下示例从共管购买和销售协议中提取信息,您可以在 提取信息的问题优化 部分中查看这些内容。
提取实体
提取卖家名称和优惠到期日期:
结果:
提取复选框信息
根据文档中标记的复选框,提取有关未包含项的信息:
结果:
提取签名状态
提取有关协议是否已签署的信息:
结果:
提取实体列表
提取买家姓名列表:
结果:
示例:从表中提取信息
此示例从以下文件中提取信息:
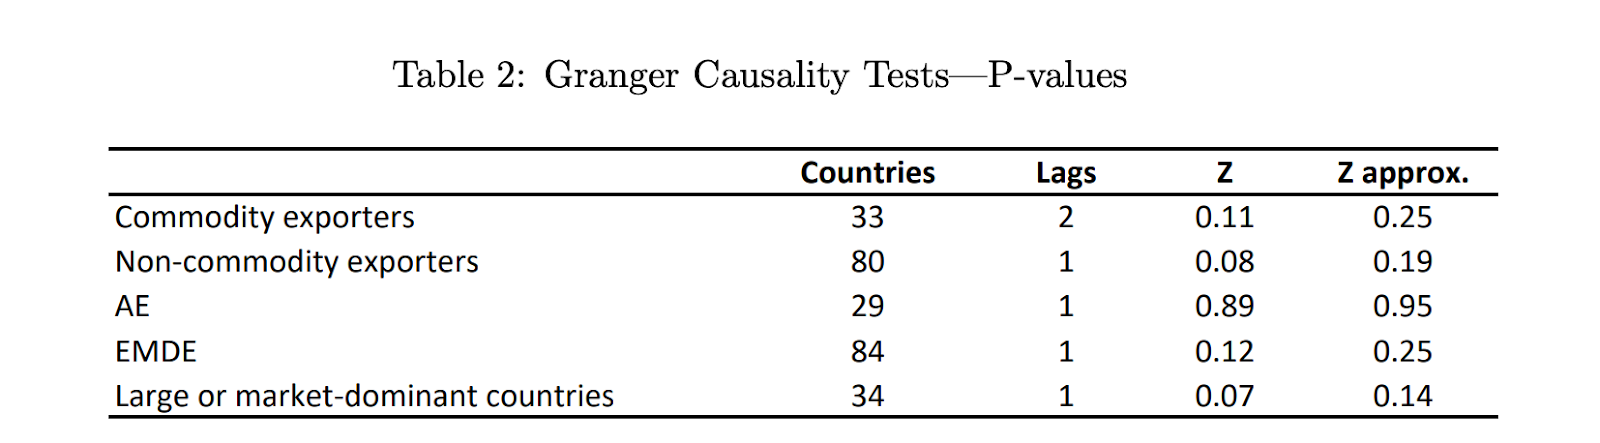
结果:
法律声明
输入和输出的 Data Classification 如下表所示。
输入 Data Classification |
输出 Data Classification |
|---|---|
Usage Data |
Customer Data |
有关更多信息,请参阅 Snowflake AI 和 ML。